Как мы дали ИИ-агенту память: pgvector и retrieval вместо fine-tuning
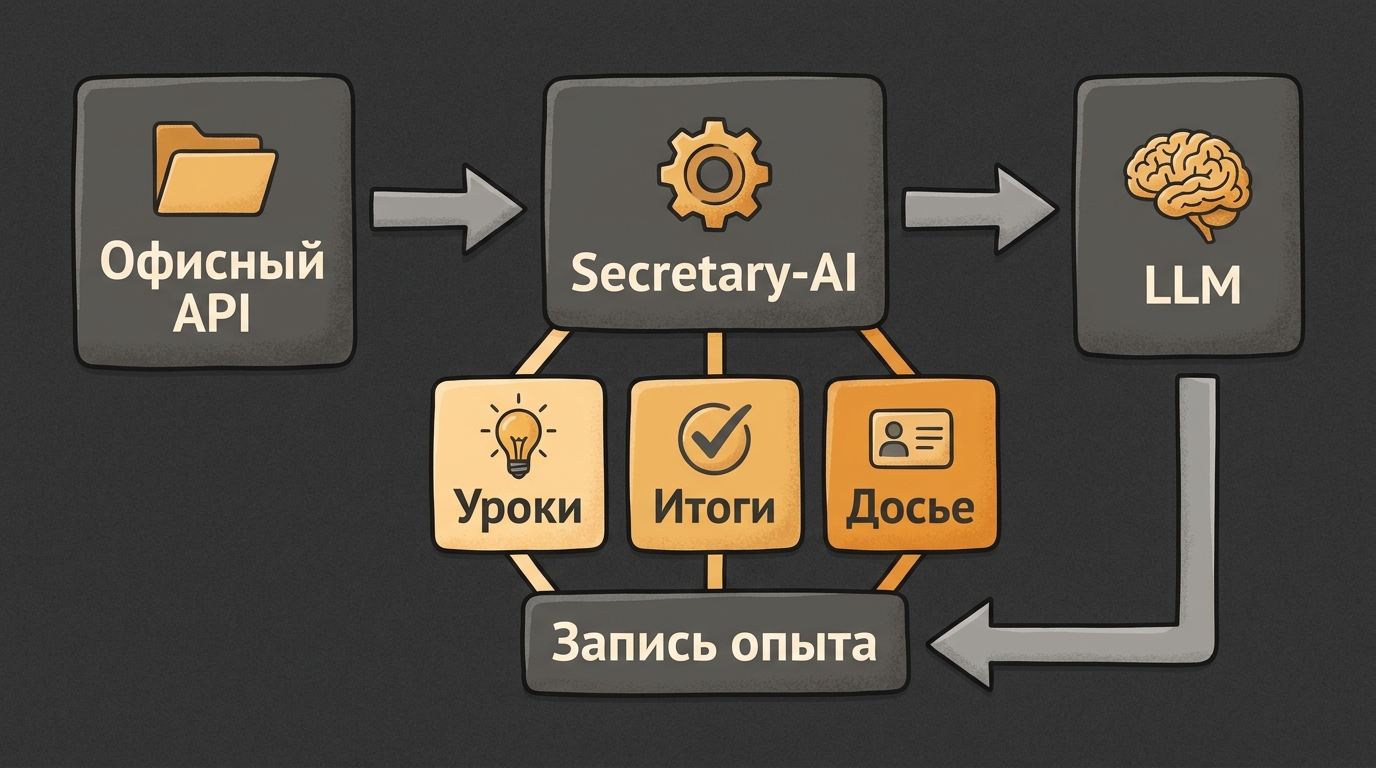
У нас был обычный ИИ-агент секретаря: разбирал клиентов, ставил задачи менеджерам, фиксировал результаты касаний. Внутри — LLM-движок, сверху — наш офисный API. И всё вроде бы работало — ровно одну итерацию.
А дальше начиналось знакомое. В понедельник он предлагал ветклинике зайти через прайс. Во вторник — снова через прайс. В среду — опять через прайс, хотя менеджер ещё в понедельник записал в CRM, что клиника про цены слышать не хочет и её волнует поток пациентов. Агент про это, конечно, не помнил: каждый цикл он начинал с чистого листа.
Ещё он стабильно дублировал задачи, не помнил прошлых возражений и генерил один и тот же сценарий одному и тому же клиенту неделю подряд. Промпт распухал от ручных правок — «а вот тут ещё учти, что…», — а весь опыт между касаниями просто испарялся. Так себе автономный ИИ-агент.
Логичный путь — fine-tuning. Мы пошли другим.
Почему не fine-tuning и не самая мощная модель
Первая идея была наивная: возьмём модель посильнее, и она сама вырулит. Подняли на пробу Claude Opus через прокси — и уткнулись в инфраструктуру. Вызовы через CLI-subprocess давали 75–150 секунд на запрос, а Cloudflare режет соединение на сотой секунде. Половина запросов отваливалась по таймауту, и это было не поправить косметически: сам механизм вызова добавлял слишком много накладных.
Fine-tuning отвалился по другим причинам:
- датасет внутренних касаний — десятки строк в неделю, не тысячи;
- любая правка регламента работы секретаря потребовала бы переобучения;
- стоимость и время на каждый цикл несопоставимы с тем, как быстро меняется бизнес-логика.
Плюс была неприятная мысль, которую в чате техкоманды озвучил один из ребят: даже если мы дообучим модель на своих кейсах, объяснить менеджеру, почему агент вдруг предложил именно этот сценарий, будет невозможно. Fine-tuning размазывает знания по весам, и потом не покажешь пальцем, откуда конкретно взялся ответ.
Решение оказалось банальным. Оставили LLM-движок (стабильные 10–30 секунд на ответ, GigaChat Pro в проде плюс запасной вариант) и подвесили сбоку retrieval-слой, который подмешивает опыт прошлых касаний прямо в системный промпт. Гибрид собрался за неделю и не требовал переучивать модель.
Архитектура: secretary-ai как отдельный микросервис
Память вынесли в отдельный сервис, а не в монолит офисного API. Так его проще масштабировать, перезапускать и в перспективе подключать к другим агентам — у нас в компании это не единственный ИИ-агент, и общая платформа ИИ-агентов постепенно вырисовывается сама собой.
Стек скучный и дешёвый — специально:
- FastAPI на VPS;
- PostgreSQL с расширением pgvector;
- sentence-transformers, модель
paraphrase-multilingual-MiniLM-L12-v2(384 измерения, мультиязычная, работает на CPU); - HNSW-индекс по векторным колонкам.
Embedder крутится локально, на той же VPS. Это принципиальный момент: никаких внешних API за эмбеддинги, никаких счётчиков токенов, никакой латентности на каждом запросе. Модель весит около 500 МБ, инференс одного предложения — десятки миллисекунд. Плюс данные не улетают наружу, что для нас важно и по 152-ФЗ, и по договорам с корпоративными заказчиками.
В pgvector лежат три типа сущностей:
- lessons — короткие выводы, которые секретарь делает после касания («для ветклиник холодный заход через прайс не работает, нужен кейс с похожей клиникой»);
- outcomes — фактические результаты касаний с привязкой к клиенту и каналу;
- dossiers — векторизованные досье клиентов на основе карточек CRM.
Схема таблицы для lessons примерно такая:
create table lessons (
  id           bigserial primary key,
  client_type  text not null,
  channel      text,
  summary      text not null,
  embedding    vector(384) not null,
  created_at   timestamptz default now()
);

create index lessons_embedding_idx
  on lessons using hnsw (embedding vector_cosine_ops);
Ничего экзотического. Именно в этом и смысл.
Как работает retrieval перед вызовом LLM
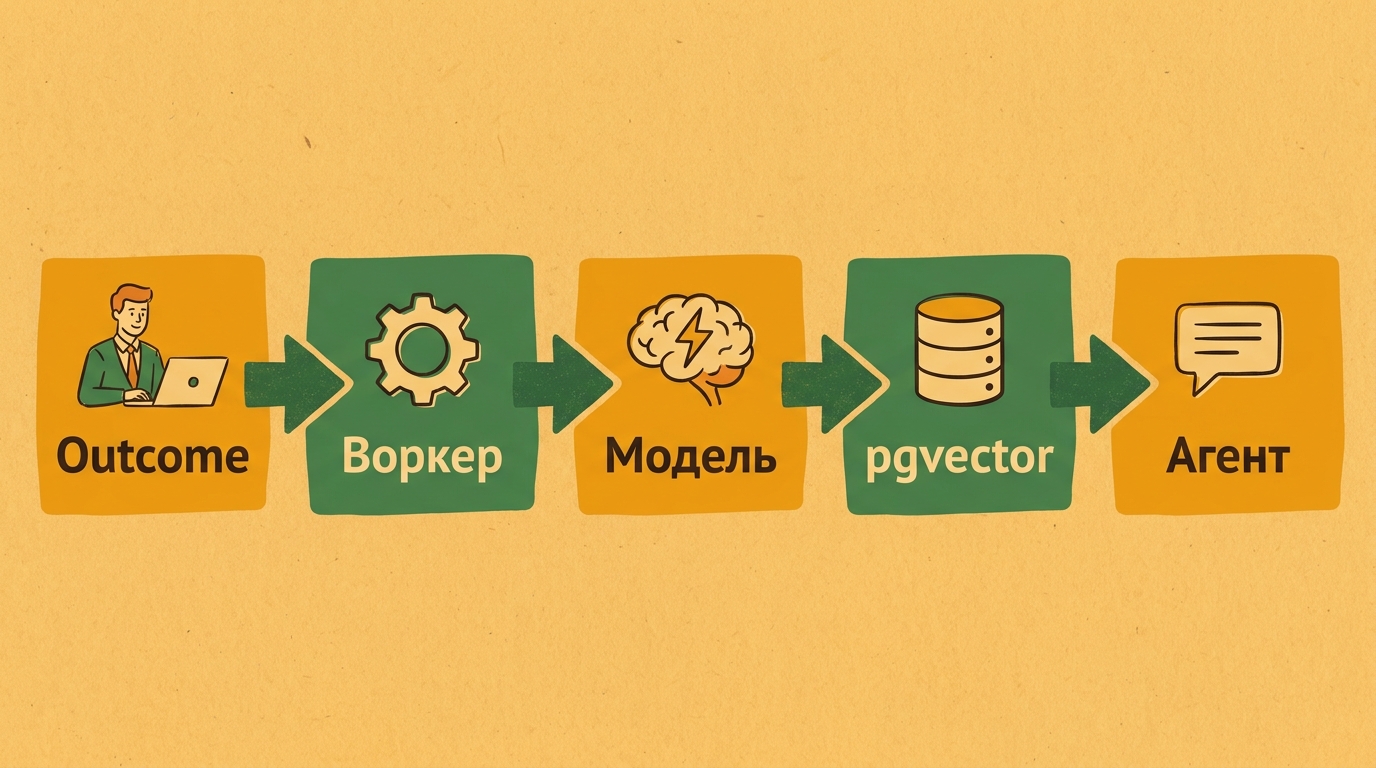
Поток такой. Офисный API готовит контекст для очередного цикла секретаря по конкретному клиенту. Перед формированием итогового промпта он стучится в secretary-ai и просит «похожий опыт».
Внутри secretary-ai:
- Текущий контекст клиента эмбеддится той же моделью.
- По cosine similarity достаём top-5 lessons и top-3 outcomes.
- Параллельно подтягиваем dossier клиента, если он есть.
- Форматируем всё это в RAG-блок и возвращаем строкой.
В системном промпте есть плейсхолдер {{relevant_experience}}, куда этот блок и подставляется. Модель видит не абстрактные инструкции, а конкретные прошлые ситуации с похожей геометрией: «вот что мы пробовали, вот что сработало, вот где обожглись».
Latency всей retrieval-операции — меньше 500 мс на HNSW-индексе. На фоне 10–30 секунд ответа LLM это вообще не заметно.
Первую версию, кстати, мы собрали без HNSW — на честном последовательном скане. На тестовом объёме это работало, а как только реальные касания пошли валом, запросы начали заметно проседать. Индекс добавили за полдня, и график latency вернулся к плинтусу.
Замыкание цикла: write-back после каждого касания
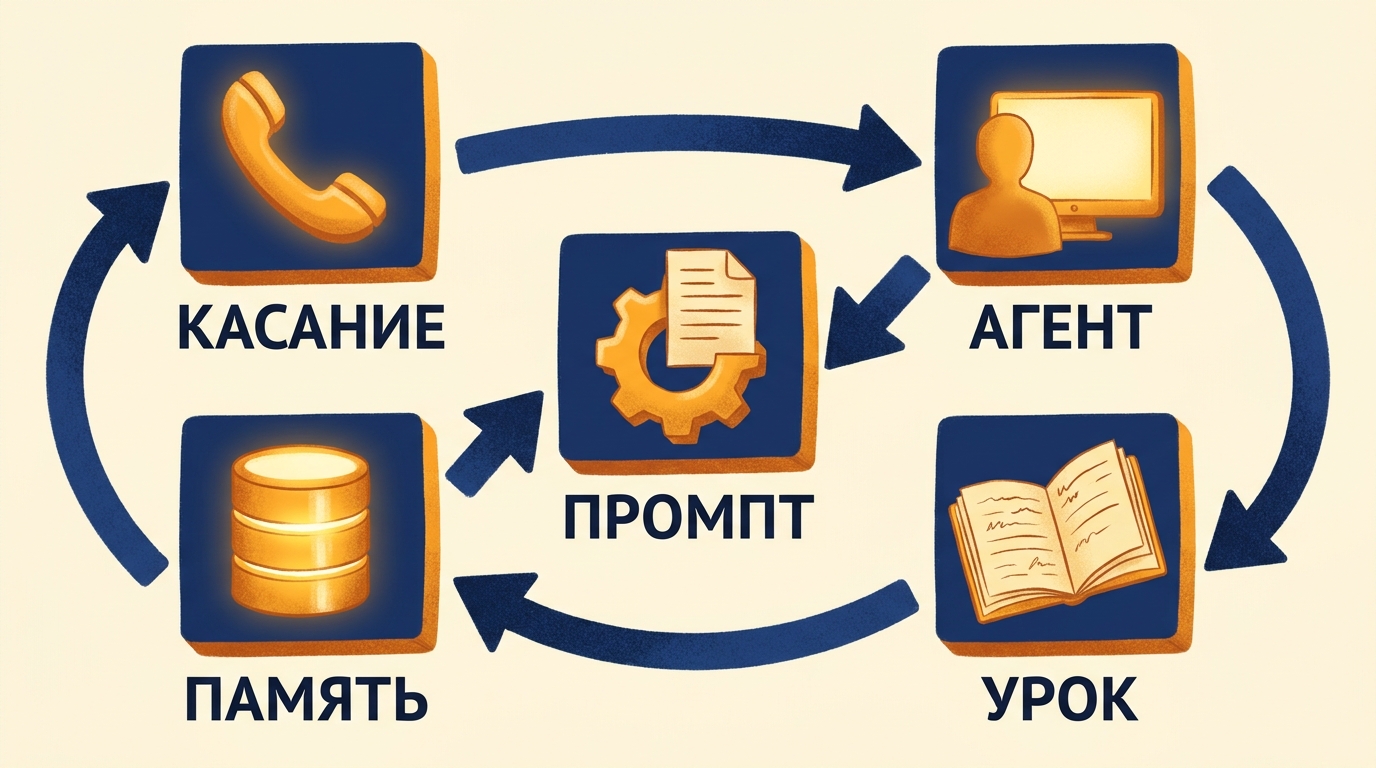
Retrieval без write-back — это просто красивая база знаний, которая со временем стухнет. Мы замкнули цикл.
После каждого результата касания офисный API дёргает secretary-ai и пушит туда:
- новый lesson — короткий вывод, который сам движок LLM генерирует в отдельном служебном вызове;
- новый outcome — фактический результат с метаданными (канал, дата, статус);
- обновлённый dossier, если карточка клиента поменялась.
Каждая запись эмбеддится при вставке и сразу попадает в HNSW-индекс. Уже следующее касание этого или похожего клиента увидит свежий опыт.
Это и есть тот самый цикл обучения, ради которого обычно тащат fine-tuning: агент сам накапливает контекст, который сам же через retrieval и использует. По сути, из «умного скрипта» получаются автономные ИИ-агенты, которые постепенно становятся лучше без ручного вмешательства инженера.
Отдельная история — что писать в lesson. Первую неделю мы дали LLM полную свободу, и он честно писал банальности вроде «важно быть вежливым с клиентом». Пришлось прикрутить отдельный служебный промпт, который явно требует: короткий вывод, что именно сработало или не сработало, привязка к типу бизнеса и каналу, без общих слов. После этого база начала наполняться содержательно.
Что получили на практике
Числа приводить не буду — статистика на таком объёме была бы кокетством. Скажу качественно.
За первую пару недель:
- база lessons из пустой превратилась в осмысленный конспект по нашим типам клиентов;
- retrieval-слой держит ответ уверенно ниже полусекунды;
- стоимость всей этой инфраструктуры — копейки на VPS, эмбеддер бесплатный;
- ни одной миграции LLM, ни одной строчки fine-tuning-кода.
По ощущениям менеджеров, которые с этим агентом работают ежедневно:
- перестал предлагать одно и то же одному и тому же клиенту;
- начал узнавать паттерны по типам бизнеса — «холодный звонок ветклинике начинай с конкретики, а не с прайса»;
- почти перестал плодить дубли задач, потому что видит свои же прошлые outcomes;
- лучше держит тон, накопленный в dossier — раньше он у одного и того же клиента гулял от «дорогого партнёра» до «привет!».
Не всё было гладко. Первую неделю секретарь регулярно вытягивал не тот опыт: например, к производственной компании подтягивал уроки из работы с медициной, потому что в тексте карточки мелькали слова про «пациентов» и «поток». Пришлось добавить фильтрацию по client_type до векторного поиска, а не только по similarity. Стало заметно точнее.
Кому такой подход подходит
Часто спрашивают: «А нам такое надо? Может, проще купить готового ИИ-агента у вендора?» Ответ зависит от того, что у вас за задача.
Retrieval поверх собственных данных выигрывает, когда:
- агент работает в цикле, где между итерациями накапливается контекст;
- бизнес-логика меняется быстрее, чем имеет смысл переобучать модель;
- объём данных — сотни-тысячи записей, а не десятки миллионов;
- нужна объяснимость: какой именно прошлый опыт повлиял на конкретный ответ (для B2B это обычно критично).
Если это про вас — pgvector-подход вытягивает почти всё. Если задача звучит как «дай нам чат-бота, который отвечает на типовые вопросы» — это ближе к ИИ-ассистенту, и там часто хватает более простых архитектур. Разница между ИИ-агентом и ИИ-ассистентом как раз здесь: агент действует в цикле и накапливает опыт, ассистент отвечает на разовые вопросы. Путать их — верный способ переплатить за архитектуру или, наоборот, недобрать функциональности.
Что мы вынесли как архитектурное правило
Первая реакция на «модель тупит» — попробовать модель посильнее. Иногда это правильно. Чаще — нет.
В нашем случае LLM не тупила. Ей просто не хватало контекста: она не знала, что мы уже пробовали с этим клиентом и чем закончилось. Как только мы дали ей доступ к собственному прошлому через pgvector, проблема исчезла без смены движка.
Retrieval — это дешёвый способ дать LLM память. Часто он закрывает большую часть задач, ради которых люди затевают fine-tuning или миграцию на топовую модель. Начинайте с него — и только если упрётесь в потолок, идите дальше.
Похожие статьи
- Как мы учим ИИ-агента не наступать на одни и те же грабли: память на pgvector вместо fine-tuning
- MCP + pgvector: как мы дали ИИ-агенту доступ к корпоративной памяти за один вечер
- Как мы научили ИИ-агента учиться на своих же сделках без fine-tuning
- Pool of 5 pending tasks: почему очередь задач для ИИ-агента — это не FIFO