Обучение ИИ-агента для отдела рекламаций: почему «лучшие ИИ-агенты» из рейтингов не сели на живой поток
К нам пришёл заказчик — крупный поставщик техники для строительных подрядчиков. У них в отделе рекламаций восемь человек, и каждый разгребает почту, чаты в мессенджерах и электронные обращения с портала. Одно и то же по кругу: где мой заказ, почему пришло не то, где акт, кто оплатил, куда звонить. Половина писем — про одни и те же три-четыре сценария. Люди устают, отвечают шаблонами, но всё равно упираются в потолок по скорости.
Директор по клиентскому сервису открыл нам разговор простой фразой: «Мы посмотрели рейтинги, там пишут про лучшие ИИ-агенты. Возьмите один из них, посадите на нашу почту, и пусть отвечает сам». Так началась история, где мы честно пытались взять готовое, потом честно пытались доучить чужое, а в итоге собрали своё. И самая интересная часть оказалась не в архитектуре, а в обучении.
Почему «лучшие» не сели на живой поток
Первым делом мы честно взяли то, что рекомендуют в открытых обзорах. Прошлись по нескольким готовым платформам — тем самым, которые в рейтингах называют лучшими ИИ-агентами для клиентского сервиса. Подключили к тестовой почте, скормили несколько сотен реальных писем из архива, поставили правило «если не уверен — молчи и передай человеку».
Через неделю картина была такая: агент отвечал бодро, но не туда. Он путал заказ с договором, поставку со счётом, отгрузку с приёмкой. Клиент пишет «где мой акт по 42-му», а агент честно рассказывает про статус доставки. Формально ошибки нет, а по сути — не ответил.
Причина оказалась банальной. Готовый агент обучен на среднем клиентском обращении из всей вселенной, а у нашего заказчика — своя терминология, свои сокращения, свои цепочки согласования. «Красная накладная», «серый вариант», «форма от главного» — эти слова в компании понимают все, а для стандартного агента они пустой шум. Никакой рейтинг здесь не помогает: рейтинги измеряют средние навыки на средних данных.
Яндекс ИИ-агент и честный компромисс
Дальше мы взяли Яндекс ИИ-агента — заказчик хотел российский контур и хранение переписки внутри страны. По базовому диалогу этот вариант отработал заметно лучше готовых зарубежных: русский язык естественный, интеграция с почтой и календарём делается спокойно, стоимость понятная.
Но и здесь мы упёрлись в тот же барьер. Яндекс ИИ-агент из коробки не знает, что «форма от главного» — это акт сверки, подписанный финансовым директором с той стороны. Он не знает, что «серый вариант» — это техника, ввезённая по параллельному импорту, и по ней особая процедура рекламации. Он не знает, что заявка с портала и заявка из мессенджера ведут в разные учётные системы.
Мы могли бы обвешать его инструкциями в промпте, но получилась бы простыня на несколько экранов, которую агент к третьему абзацу уже начинает интерпретировать по-своему. Пришло время признать: без нормального обучения ИИ-агента на данных самой компании ничего человеческого не выйдет.
Что мы называем обучением, а что — нет
Тут важно расшифровать слово, вокруг которого много путаницы. Когда мы говорим «ИИ-агенты обучение», заказчики чаще всего представляют fine-tuning: взяли модель, скормили ей все письма за три года, получили умного клона отдела. На практике так почти никто не делает, и вот почему.
Fine-tuning большой модели под конкретную компанию — это дорого, долго и хрупко. Как только у клиента поменяется процесс — а он меняется каждый квартал — придётся дообучать заново. Плюс на выходе получаешь чёрный ящик, в котором непонятно, почему агент вдруг стал путать номера договоров.
Поэтому под обучением мы имеем в виду другое: набор согласованных решений, из которых складывается поведение агента. Это и структурированная база знаний с RAG поверх pgvector, и разбор реальных диалогов с разметкой «здесь агент правильно передал человеку, здесь ошибся», и словарь внутренних терминов, и правила эскалации. Плюс регулярные короткие сессии, где менеджер отдела говорит: «Вот здесь агент не должен отвечать вообще, это разговор про деньги».
Разработка ИИ-агентов начинается с разбора чужих писем
Мы посадили аналитика на две недели просто читать переписку отдела рекламаций. Не размечать, не обучать модель, а именно читать. Он выписал типовые сценарии, повторяющиеся вопросы, слова, которых нет в словарях, и, что важнее всего, места, где менеджеры сами не уверены, что отвечать.
Из этой работы родилась карта: около двадцати сценариев, из которых пятнадцать агент может закрыть сам, три — только собрать данные и передать человеку, два — вообще не трогать. Разработка ИИ-агентов, если она про бизнес, а не про демо, всегда начинается с такой карты, а не с выбора модели.
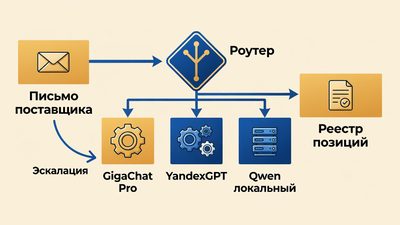
Модель мы взяли GigaChat Pro. Для рекламаций хватает её умений в русском, а требование хранить переписку в российском контуре снимает половину вопросов юридического отдела. Векторный поиск — pgvector поверх PostgreSQL, в которой у заказчика и так живут учётные данные. MCP-сервер связал агента с 1С, порталом заявок и внутренним справочником сотрудников.
Как мы учили агента после запуска
Первые недели после запуска — самая недооценённая часть работы. Мы отвели этому времени столько же, сколько на саму разработку.
Каждый день менеджер отдела и наш инженер садились и разбирали случайную выборку диалогов. Не все подряд — это невозможно, — а несколько десятков. Смотрели, где агент ответил хорошо, где криво, где промолчал зря, где заговорил зря. Ошибки не чинили точечно правкой промпта — записывали в отдельный список и раз в неделю смотрели, что накопилось. Часто оказывалось, что пять разных на вид ошибок — это одна причина, и её лечит одно исправление в базе знаний.
К концу второго месяца агент закрывал сам большую часть типовых обращений, а менеджеры разбирали только то, что действительно требовало живого разговора. Раньше на разгребание почты уходил рабочий день у двоих человек — теперь эта работа заканчивается до обеда, и её делает один. Не потому что мы уволили половину отдела, а потому что освободившееся время люди наконец тратят на сложные случаи, до которых руки не доходили.
Что стоит унести из этой истории
Первое: рейтинги лучших ИИ-агентов — полезный ориентир, чтобы не смотреть на совсем странные продукты, но выбор по рейтингу без пилота на своих данных почти всегда заканчивается разочарованием. Средний агент хорош в среднем, а у вас — конкретный отдел с конкретным словарём.
Второе: Яндекс ИИ-агент, GigaChat, YandexGPT — сильные базовые кирпичики для российского контура, но без обучения на данных компании они остаются вежливыми универсалами. Полезность появляется, когда поверх модели ложится карта сценариев, база знаний и словарь.
Третье, и самое важное. Обучение ИИ-агентов — это не разовая процедура перед запуском, а постоянная работа менеджера, который лучше всех знает свой участок. Наша задача как разработчиков — сделать этот процесс простым: собрать интерфейс, где менеджер поправит формулировку в базе знаний за минуту, а не откроет тикет к нам на неделю. Тогда агент не деградирует, а взрослеет вместе с отделом.
И последнее наблюдение, которое мы вынесли из этого проекта. Люди в отделе рекламаций боялись, что их заменят, а через пару месяцев начали просить: «А можно агенту ещё вот эту задачу отдать?». Хороший ИИ-агент в B2B не заменяет команду, а разгружает её от того, что и так делалось на автомате. Разница между «купили лучшего из рейтинга» и «сделали своего» — примерно вот в этой фразе от людей, которые с ним работают каждый день.
Похожие статьи
- Один ИИ-агент — три модели: как мы разложили шаги между GigaChat Pro, YandexGPT и локальным Qwen
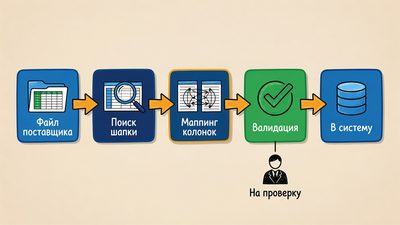
- Excel от клиента приходит каждый раз новый: как мы создали ИИ-агента для разбора выгрузок, с которыми не справилась ни одна регулярка
- Красная папка: как мы учим ИИ-агента после запуска и не чиним всё подряд
- Стенд вместо чужих бенчмарков: как мы проверяем ИИ-агентов для бизнеса перед сдачей