Один ИИ-агент — три модели: как мы разложили шаги между GigaChat Pro, YandexGPT и локальным Qwen
В отдел снабжения крупного производителя каждую неделю падают десятки коммерческих предложений от поставщиков. Форматы разные: где-то аккуратная таблица в PDF, где-то скан времён Windows XP, где-то письмо, в котором цена спрятана в третьем абзаце после поздравлений с наступающим. Раньше специалист вручную сводил всё это в один реестр, чтобы закупщик мог выбрать лучшую позицию. Работа скучная, точная и на весь день.
Нам поставили задачу: сделать ИИ-агента, который берёт письмо, вытаскивает позиции с ценами и складывает их в общую таблицу. Задача звучит понятно, пока не начинаешь считать деньги за токены.
ИИ-агент — что это, если смотреть под капот
Когда клиент спрашивает, ИИ-агент — что это такое, проще всего ответить: это не одна большая языковая модель, а связка из нескольких шагов, каждый из которых модель выполняет по своему промпту. Один шаг вытащит текст, второй распознает структуру, третий сверит с справочником номенклатуры, четвёртый сформирует ответ. И вот тут возникает вопрос, о котором на старте почти никто не думает: обязательно ли все эти шаги должны крутиться на одной и той же модели?
Мы долго считали, что да. Оказалось — нет.
Первый заход: всё в одну топовую модель
Первый прототип мы собрали по учебнику: одна мощная модель на все шаги, весь пайплайн через неё. Работало красиво — качество вытяжки высокое, справочник понимает, спорные случаи разруливает почти как живой специалист.
Потом пришёл счёт за месяц пилота, и разговор с заказчиком стал неприятным.
Мы посмотрели, что происходит внутри. Оказалось, из десяти шагов агента серьёзного рассуждения требуют два-три: сопоставить нестандартное наименование со справочником, разобрать неоднозначную скидку, свести противоречия в письме. Всё остальное — механическая работа: выдели текст, приведи к формату, проверь по регулярке, посчитай сумму. На эти шаги мы тратили деньги топовой модели, а она там нужна была примерно как экскаватор для посадки герани.
Второй заход: разделили роли внутри агента
Мы переписали агента так, чтобы каждый шаг выбирал себе исполнителя по сложности задачи. Получилась не одна модель, а маленькая команда.
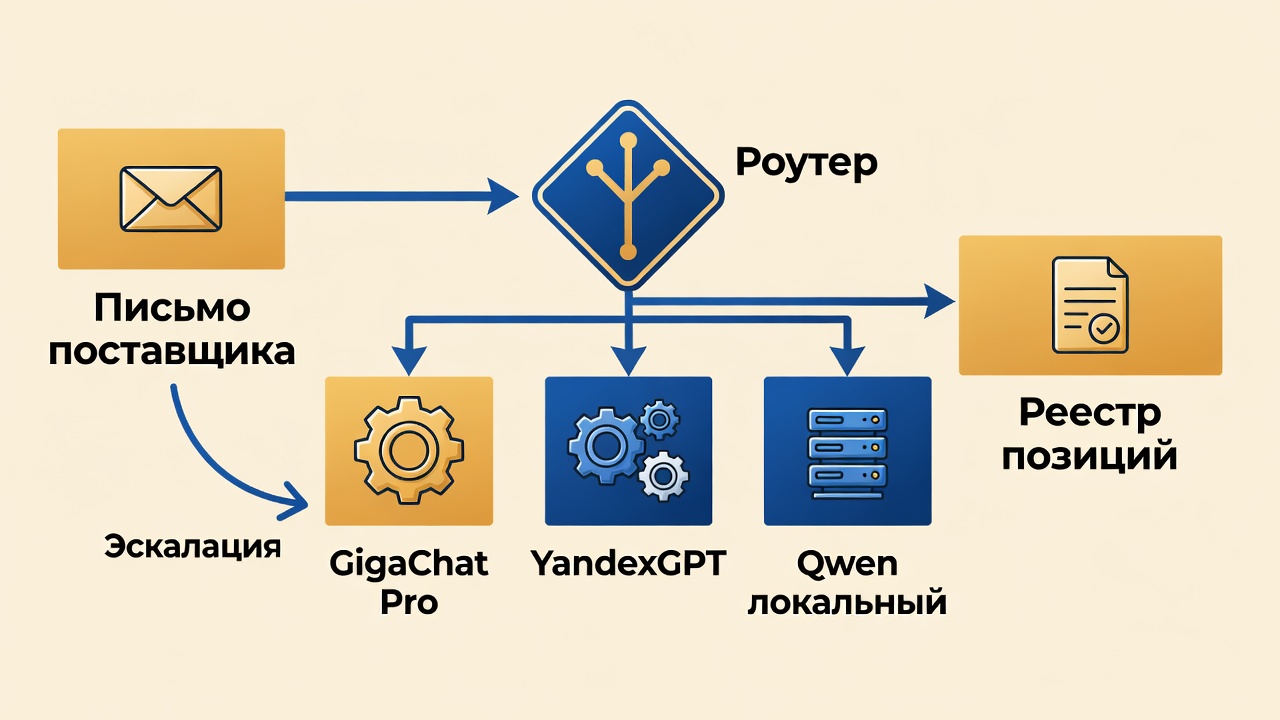
- GigaChat Pro — тяжёлые смысловые шаги. Сопоставление номенклатуры со справочником заказчика, разбор противоречивых условий поставки, финальная сверка. Здесь важно понимать контекст и держать в голове детали письма.
- YandexGPT — средние задачи. Классификация письма по типу (КП, счёт, уточнение), извлечение реквизитов поставщика, выделение позиций из более-менее структурированного текста.
- Локальный Qwen на нашем сервере — рутина. Очистка текста от подписей и юридических футеров, нормализация единиц измерения, приведение дат к единому виду.
Ключевой вопрос: как агент решает, к какой модели пойти на следующем шаге? Мы вынесли это в отдельный слой — роутер, который смотрит на тип шага, объём текста и наличие маркеров сложности. Если, например, в позиции больше одного возможного матча в справочнике — уходим наверх, к тяжёлой модели. Никакой магии, просто правила и небольшой классификатор, тоже локальный.
Где мы едва не сломали агента
Поворот случился на второй неделе после переезда на многомодельную схему. Агент вдруг начал терять точность на сопоставлении позиций. Разбираемся — оказывается, роутер слишком часто отправлял «неоднозначные» кейсы на среднюю модель. Она давала на первый взгляд разумный ответ, и агент шёл дальше, не подозревая, что выбор был неверный.
Пришлось добавить обратную петлю: если средняя модель не уверена в ответе (мы просим её саму помечать результат как «есть варианты»), задача эскалируется на тяжёлую. Это стоит дороже, чем сразу отправить наверх, но всё равно ощутимо дешевле, чем гонять топовую модель на всём подряд. И качество вернулось.
Это, кстати, важный момент про создание ИИ-агента для бизнеса: маршрутизацию нельзя настроить один раз и забыть. Первые недели вы её постоянно докручиваете, потому что реальные письма всегда сложнее, чем вы себе представляли.
Что даёт такая схема, кроме экономии
Первое и очевидное — счёт за модели ощутимо меньше. Не в разы, но настолько, что заказчик перестал спрашивать: «А не дешевле ли будет держать двух человек?»
Второе, менее очевидное — устойчивость. Когда у вас три поставщика моделей, вы меньше зависите от того, что у одного из них случился сбой или подорожал тариф. Локальная модель вообще работает у клиента внутри периметра: если завтра отвалится всё внешнее, рутинные шаги продолжат идти.
Третье — контроль над данными. Часть писем содержит цены и условия, которые заказчик не готов светить в облако. Локальный Qwen обрабатывает такие фрагменты у клиента, а наружу уходит только уже обезличенный смысловой запрос, если он вообще нужен. Это отдельный разговор с юристами и безопасниками, и с многомодельной схемой он идёт заметно легче.
Как создать ИИ-агента с маршрутизацией, если вы только начинаете
Несколько вещей, которые мы вынесли из этой истории и теперь закладываем в разработку ИИ-агентов с самого начала.
Не выбирайте модель до того, как разложили агента на шаги. Классическая ошибка — сначала утвердить «делаем на такой-то модели», а потом натягивать её на все задачи. Правильный порядок обратный: сначала список шагов, потом на каждом шаге вопрос — какая модель тут минимально достаточна.
Роутер должен быть простым и объяснимым. Мы пробовали делать выбор модели через отдельную большую LLM — получилось дорого и непредсказуемо. В итоге у нас работает связка из правил и маленького локального классификатора. Когда что-то идёт не так, инженер за пять минут понимает, почему роутер принял именно такое решение.
Заложите петлю эскалации. Средняя модель обязательно будет иногда ошибаться уверенно. Если у вас нет механизма поднять сомнительный кейс наверх, вы будете ловить эти ошибки уже на стороне пользователя, а это самый дорогой способ учиться.
Считайте не только деньги, но и латентность. Локальная модель может быть медленнее облачной на одном шаге, но зато не ходит по сети. Иногда суммарный ответ агента получается быстрее именно потому, что часть шагов не улетает в интернет.
Что в итоге
ИИ-агенты для бизнеса — это почти всегда история про баланс. Хочется, чтобы работало быстро, дёшево, качественно и внутри периметра. На одной модели все четыре галочки поставить сложно. На связке из трёх — вполне реально, если честно разобрать задачу на шаги и не пытаться сэкономить на роутере.
У нас в снабжении заказчика раньше на сведение недельной пачки предложений уходил рабочий день сотрудника. Теперь справляются до обеда, а человек тратит время на то, ради чего его вообще нанимали — на переговоры с поставщиками, а не на копирование строчек в таблицу. По-моему, это и есть тот случай, ради которого стоит связываться с созданием ИИ-агента.
Похожие статьи
- Excel от клиента приходит каждый раз новый: как мы создали ИИ-агента для разбора выгрузок, с которыми не справилась ни одна регулярка
- Красная папка: как мы учим ИИ-агента после запуска и не чиним всё подряд
- Стенд вместо чужих бенчмарков: как мы проверяем ИИ-агентов для бизнеса перед сдачей
- «Хочу ИИ-агента прямо на ноутбук, как у Perplexity»: разбираемся, какие есть ИИ-агенты для ПК и что реально стоит покупать