Excel от клиента приходит каждый раз новый: как мы создали ИИ-агента для разбора выгрузок, с которыми не справилась ни одна регулярка
Знакомая картинка: заказчик присылает выгрузку номенклатуры «на согласование» — файл Excel, в котором первая строка не заголовок, а название прайса, вторая пустая, третья снова текст, а настоящие заголовки лежат где-то на седьмой строке. Часть колонок называется «Кол-во», часть — «шт», часть — «qty», а в одной ячейке кто-то заботливо приписал от руки «уточнить у Николая». И такие файлы приходят каждую неделю от разных поставщиков, и каждый раз структура немного другая. Именно на такой задаче мы в очередной раз убедились, зачем нужны ИИ-агенты для бизнеса и чем они отличаются от «просто вызовем модель».
Почему регулярки и словари здесь сдаются
Первое, что делает любой инженер: пишет маппинг. Словарь синонимов колонок, десяток регулярок на распознавание единиц измерения, пара правил «если сумма в конце листа — это итог, а не строка». Пару недель это работает.
Потом приходит файл, где артикул склеен с наименованием через дефис, а количество вынесено в объединённую ячейку сверху блока. Ты дописываешь ещё одно правило. Через месяц правил становится сто, и они начинают конфликтовать. Отдел, который «просто сверял накладные», превратился в отдел, который сверяет накладные и чинит парсер.
К этому моменту становится очевидно: сама постановка неправильная. Мы пытались описать правилами задачу, которая по природе требует понимания, а не сопоставления. Понимание — это и есть то, ради чего вообще нужны большие языковые модели.
ИИ-агент — что это в такой задаче
Термин затаскан, поэтому уточню, как я его использую здесь. ИИ-агент — это не однократный вызов модели «разбери мне файл». Это связка из четырёх вещей: восприятие входа, план действий, вызов инструментов и проверка результата. Модель — только один из компонентов, и часто не самый умный. Умное — то, как обвязка ловит модель за руку.
В нашей задаче агент получает файл, сам решает, где заголовки, сам сопоставляет колонки со своей внутренней онтологией, сам обращается к базе за проверкой артикулов, сам решает, что вот эту строку он не понимает и надо отдать человеку. Если внутри одна из этих ролей ломается — ломается вся цепочка. Отсюда и подход.
Как мы создали ИИ-агента: не с промпта, а с онтологии
Первое, что мы сделали при разработке — не открыли редактор промптов, а сели с клиентом и выписали все поля, которые он в принципе ожидает увидеть в выгрузке. Артикул поставщика, наш внутренний код, наименование, количество, единица измерения, цена без НДС, цена с НДС, скидка, срок поставки, комментарий. Штук пятнадцать сущностей и десяток вариантов, как каждую из них может назвать живой человек.
Дальше — принципиально: агент не «угадывает колонки», а сопоставляет их с этим списком. Если модель не уверена, к какой сущности отнести колонку «остаток на складе поставщика» — это не количество для заказа, это отдельная сущность, и её либо надо добавить, либо честно отбросить. Онтология — та кость, вокруг которой всё держится.
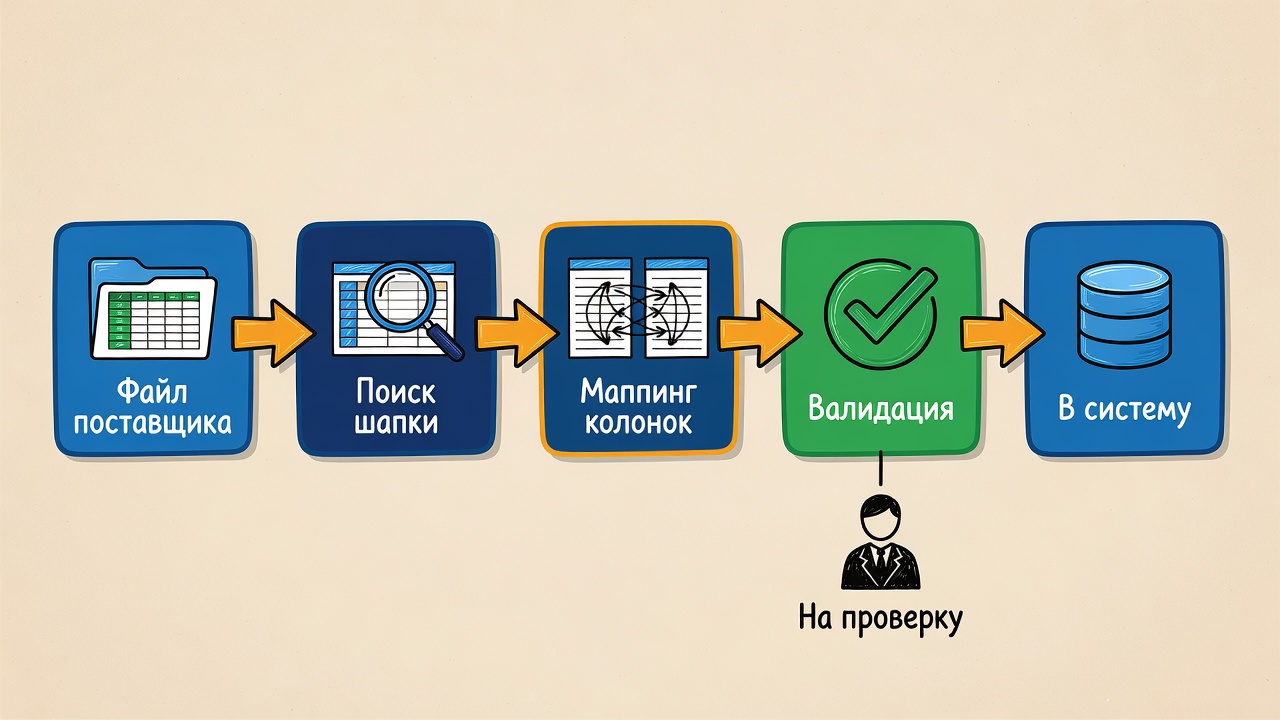
Пайплайн получился такой:
- Загружаем файл, разбиваем на листы, для каждого просим модель найти строку с заголовками. Модель видит первые двадцать-тридцать строк, ищет прямоугольник данных.
- Достаём заголовки, отдаём модели на маппинг к нашей онтологии. Каждой колонке — метка из фиксированного списка или «неизвестно».
- Для каждой строки прогоняем валидацию: артикул существует в справочнике, количество — число, единица измерения — из списка допустимых.
- Всё, что не прошло валидацию, идёт в очередь на разбор человеку. Не в мусор — в отдельный лист с пометкой, чего именно не хватило.
Модель здесь трогает только два места: определение шапки и маппинг колонок. Всё остальное — обычный питон с проверками. Это сознательно: чем меньше мест, где модель принимает решение, тем меньше поверхности для галлюцинаций.
Где спотыкались и что доделывали
Первое, обо что споткнулись — объединённые ячейки. Модель их видела как одну ячейку с текстом в первой позиции и «None» в остальных. Пришлось делать предобработку: разъединяем merged cells и копируем значение вниз. После этого качество маппинга скакнуло вверх сразу.
Второе — единицы измерения. «шт», «штук», «pcs», «упак.», «уп», «коробка (12 шт)». Мы отдельно попросили модель нормализовать эту колонку в стандартный код. Здесь как раз пригодилась few-shot: пара десятков примеров прямо в системном промпте, и качество выровнялось.
Третье и самое неприятное — комментарии внутри числовых колонок. «120 (со скидкой 118)», «уточнить», «нет в наличии — предлагаем аналог». Модель честно пыталась вытащить число, но иногда доставала не то. Мы завели правило: если в ячейке количества найден текст помимо цифр, вся строка идёт человеку. Ошибиться на количестве в закупке дороже, чем потратить лишнюю минуту менеджера.
Четвёртое — сам выбор модели. Мы гоняли задачу на нескольких вариантах: локальный Qwen, GigaChat Pro, ещё пара. Для маппинга колонок хватило и модели поменьше — задача узкая, поле выбора ограничено онтологией. Для разбора шапки нужна была модель поумнее: там надо понимать структуру листа, а не только текст. В итоге у нас разные модели на разных шагах, и это нормально. Гонять флагман там, где справится компакт, — просто жечь бюджет.
Что изменилось в работе
Про «было-стало» без выдуманных процентов. Раньше на разбор пачки прайсов от новых поставщиков уходил полноценный рабочий день младшего менеджера. Сейчас файл прилетает в папку, через пару минут в системе появляются загруженные строки и отдельный лист «требует внимания». Менеджер открывает только этот второй лист и добивает то, что агент не смог. По ощущениям, ручной работы стало заметно меньше — но, что важнее, у менеджера освободилась голова: он больше не сверяет колонки глазами, он принимает решения по спорным строкам.
Второй эффект — неожиданный. Онтология полей, которую мы вытащили ради агента, оказалась полезной сама по себе. Клиент впервые формально описал, какие данные вообще ходят у него в закупках. Раньше это существовало только в головах трёх людей. Теперь это документ.
Что забрать из этой истории
Если коротко: ИИ-агенты для бизнеса начинают работать не тогда, когда вы подключаете модель к задаче, а когда вы формулируете задачу так, что модели остаётся сделать самую суть — сопоставление и понимание, — а всё остальное делает обычный код с валидацией. Онтология, схема, проверки, эскалация человеку. Без этой обвязки любой ИИ-агент превращается в лотерею.
И ещё одно наблюдение из десятка похожих внедрений. Когда клиент спрашивает «как создать ИИ-агента для нашей задачи», первый честный ответ — «давайте сначала опишем задачу так, будто агента не существует». Что должно получиться на выходе, какие данные мы считаем валидными, что делать с непонятным. Если на эти вопросы есть ответы — агент собирается за пару недель. Если нет — не собирается вообще, сколько ни докидывай моделей.
Похожие статьи
- Красная папка: как мы учим ИИ-агента после запуска и не чиним всё подряд
- Стенд вместо чужих бенчмарков: как мы проверяем ИИ-агентов для бизнеса перед сдачей
- «Хочу ИИ-агента прямо на ноутбук, как у Perplexity»: разбираемся, какие есть ИИ-агенты для ПК и что реально стоит покупать
- ИИ-агент для 1С после сентябрьских атак: как мы переписали правила доступа, не сломав рабочие сценарии