- Главная
- Блог
- Managed-агенты для долгих задач вышли одновременно у трёх компаний: как мы делаем то же самое на GigaChat Pro
Managed-агенты для долгих задач вышли одновременно у трёх компаний: как мы делаем то же самое на GigaChat Pro
Клиент попросил ИИ-агента, который за ночь пересобирает годовой срез по договорам: пройти по всему архиву, найти изменения, сверить с приказами и допсоглашениями, разложить результат в шаблон для внутреннего аудита. По прикидкам — задача на много часов работы, десятки тысяч документов. Первая версия была прямолинейной, как топор: одна длинная сессия, агент идёт от начала до конца, в конце возвращает результат. Работало ровно до первого падения.
Что такое ИИ-агент, когда задача не помещается в одну сессию
Обычно, когда объясняют, что такое ИИ-агент, говорят про цикл «подумал — выбрал инструмент — сделал шаг — оценил результат». Всё верно, пока задача укладывается минут в пять. Как только речь идёт о работе на часы, начинаются вопросы, которых в туториалах нет.
Что делать, если модель упала на середине? Если сервер перезагрузили? Если клиент передумал и хочет остановить агента, но не потерять уже проделанное? Если контекст диалога распух так, что дальше в модель просто не влезает?
Именно эти вопросы стали фоном для трёх новостей одной недели. OpenAI открыла публичную бету Agents API — с сессиями, оркестрацией, компакцией контекста, суб-агентами и восстановлением после сбоев. Databricks расширила Genie Agents до сотен тысяч разговоров и десятков источников данных. Salesforce выкатила сразу семерых готовых агентов внутри Agentforce с общим governance-слоем. Все три одновременно решают одну и ту же скучную инженерную проблему: как сделать так, чтобы агент жил долго и не начинал с нуля после каждой запятой.
У нас клиент российский, контур закрытый, задача на GigaChat Pro. Managed-инфраструктуры под рукой нет. Пришлось делать самим.
Первый подход: один длинный сеанс
В первой версии агент выглядел как обычный ReAct-цикл: тула для чтения документа, тула для поиска по архиву, тула для сравнения версий, тула для записи в шаблон. Всё внутри одного процесса, состояние живёт в памяти, история сообщений копится в контексте.
На тестовом наборе из сотни договоров всё было прекрасно. На реальном архиве развалилось за первую же ночь.
Сначала мы упёрлись в контекст модели. К середине работы история сообщений разрослась так, что до финального ответа доходило уже совсем не то, что было в начале. Модель забывала правила, введённые в системном промпте, путала статусы, начинала пересчитывать то, что уже посчитала.
Потом упал воркер. Не по нашей вине — плановый перезапуск на стороне клиентской инфраструктуры. И тут стало по-настоящему больно: агент перезапустился с нуля, пересчитал половину архива заново, потратил лишние токены и время. Клиенту пришлось ждать почти сутки вместо ночи.
Стало понятно: как создать ИИ-агента для такой задачи — это уже не вопрос про промпт и не вопрос про выбор модели. Это вопрос про хранение состояния и границы шагов.
Второй подход: чекпоинты, а не сессии
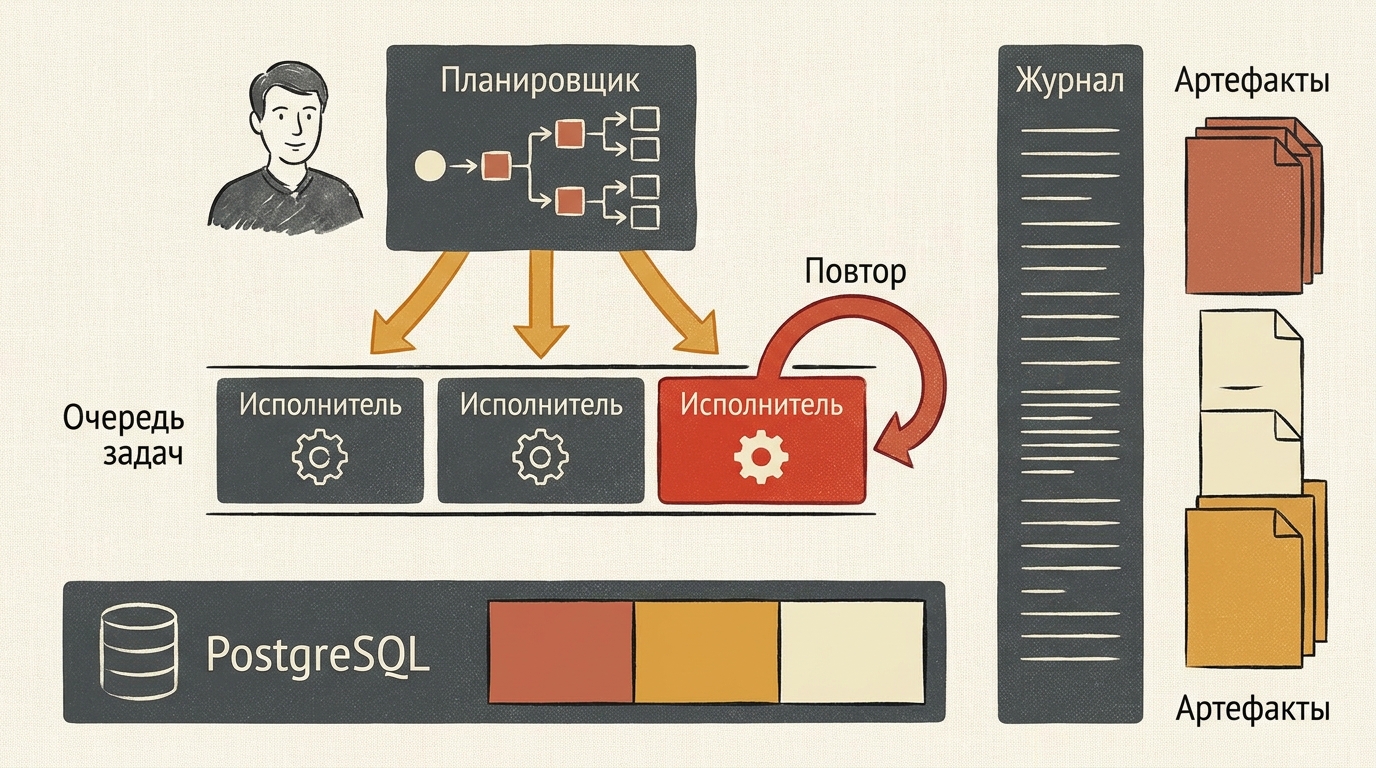
Мы переписали ядро вокруг простой идеи. У агента нет «сеанса». У агента есть план и журнал. План — это дерево задач, разложенное на конкретные шаги. Журнал — это упорядоченный список того, что уже сделано, с результатами.
Всё живёт в PostgreSQL. Одна таблица под задачи с их статусами (pending, in_progress, done, failed, skipped), вторая под события с полезной нагрузкой в JSONB, третья под артефакты (выдержки из документов, промежуточные выводы, ссылки на файлы). Каждый шаг агента — это транзакция: прочитал вход, выполнил, записал результат, обновил статус, коммит.
Такой подход даёт три вещи одновременно.
Во-первых, агента можно убить в любой момент. При следующем запуске он смотрит в таблицу задач, находит первое in_progress или pending, откатывает недоделанное по логу и продолжает. Никакой in-memory магии, никаких «а на чём мы остановились».
Во-вторых, контекст модели больше не растёт бесконечно. На каждом шаге мы собираем маленький, целевой промпт: описание конкретной подзадачи, релевантные факты из журнала (не вся история, а компакция — сводки предыдущих шагов), нужные документы. Модель получает ровно то, что нужно для одного решения, и не тонет в собственном хвосте.
В-третьих, всё становится наблюдаемым. По журналу видно, что агент делал, сколько времени занял каждый шаг, какие тулы отвалились, где модель начала галлюцинировать. Разбор инцидента превращается из раскопок в чтение таблицы.
Как разложить работу на шаги, чтобы это работало
Главный вопрос при таком подходе — не «какую модель взять», а «где резать». Слишком мелкие шаги — оверхед на запись и лишние вызовы модели. Слишком крупные — возвращается та же проблема: один шаг падает, приходится переделывать много.
Мы для себя вывели грубое правило: один шаг должен помещаться в разумное время работы модели и приводить к конкретному, проверяемому артефакту. «Прочитать один договор и вытащить из него ключевые условия» — хороший шаг. «Собрать раздел отчёта по всем договорам одного контрагента» — тоже хороший, если контрагентов не слишком много. «Обработать весь квартал» — плохой.
Дальше — иерархия. Верхний уровень плана строит другой ИИ-агент, чисто планировщик: получает вход, раскладывает на подзадачи, кладёт дерево в базу. Исполнители забирают задачи из очереди и делают своё. Если исполнитель на чём-то спотыкается, задача возвращается в очередь с флагом «повторить» или уходит человеку.
Это, если совсем упрощать, ровно то, что показывают в презентациях к managed-агентам новой волны. Сессии, оркестрация, суб-агенты, восстановление. Мы просто собрали это на своей стороне, потому что готовых российских аналогов пока нет, а завозить чужое в закрытый контур с персональными данными — не вариант.
Где мы обожглись, пока это делали
Три места, которые стоит проговорить, чтобы вы не наступили на те же грабли.
Первое — идемпотентность. Если задача упала на полпути, при повторе она не должна дважды записать один и тот же артефакт или отправить одно и то же уведомление. Мы храним natural_key для каждой операции и проверяем его перед записью. Скучно, но спасает от дублей.
Второе — компакция контекста. Мы сначала пробовали просто складывать в промпт последние N событий. Быстро оказалось, что «последние» ≠ «важные». Пришлось делать отдельный шаг, который агент делает раз в какое-то время: берёт последние решения и переписывает их в короткую сводку. Похоже на то, что теперь называют context compaction в чужих API, только руками.
Третье — граница между агентом и человеком. Некоторые шаги мы принципиально не отдаём в автомат. Например, если агент нашёл противоречие между приказом и договором, он не решает сам. Он оформляет вопрос, кладёт задачу в отдельную очередь и ждёт ответа юриста. Раньше это казалось излишеством, сейчас — то, что делает решение пригодным для аудита.
Что изменилось для клиента
Раньше ночная выгрузка иногда доезжала к следующей ночи. Теперь агент отрабатывает за одну смену, и если его посреди работы уронить, при перезапуске он продолжает с последнего чекпоинта, а не с начала. Ручной работы аудитора стало заметно меньше: он приходит утром к готовым артефактам, а не к «упало, запускайте заново». Счёт за модель тоже стал ощутимо ниже — не за счёт скидок, а за счёт того, что мы перестали пересчитывать одно и то же по три раза.
Если резюмировать: ИИ-агенты для бизнеса, которые работают дольше пяти минут, — это уже не про промпт-инжиниринг. Это про базу данных, очередь задач, идемпотентность и грамотную раскладку работы на шаги. Managed-инфраструктура, которую сейчас массово показывают крупные вендоры, снимает с разработчика ровно эту часть. Пока в российском контуре её нет, приходится собирать самим — и, честно говоря, это неплохой опыт: когда ты сам построил чекпоинты, ты хотя бы точно знаешь, что там внутри.
А вопрос, который я бы обсудил в комментариях: где для вас проходит граница между «шаг ИИ-агента» и «отдельный ИИ-агент»? Мы для себя её нашли эмпирически, но интересно, как думают другие.
Похожие статьи
- Клиент хотел включить Алису AI и Claude for Small Business в одну неделю: как кодекс использования ИИ-агентов спас проект от каши
- ИИ-агент Hermes от Nous Research обновили — мы примерили его к своей платформе ИИ-агентов и оставили себе только идеи
- Managed API или локальный ИИ-агент: как мы выбираем после сентябрьских релизов
- Заказчик подключил Яндекс ИИ-агента и позвал нас доделывать: где заканчивается универсальный помощник
