ИИ-агент забыл клиента к следующему звонку: как мы разложили память агента на три слоя
Клиент звонит второй раз за неделю — уточнить статус по своей заявке. Менеджер спрашивает вежливое «здравствуйте, чем могу помочь?». Клиент раздражается: он уже всё это объяснял в прошлый раз, зачем повторять. Только менеджера тут нет — это наш ИИ-агент на сайте. И он действительно не помнит вчерашнего разговора.
С этой мелочи и начался проект, о котором я хочу рассказать. Мы делаем ИИ-агентов для бизнеса не первый год, и в последнее время самой частой претензией стала не «отвечает медленно» и не «путает термины», а вот эта — «он меня не узнаёт». При создании ИИ-агента про память вспоминают в последнюю очередь. А зря: без памяти агент — это красивая ярмарочная кукла, которая на каждый вопрос отвечает как в первый раз.
ИИ-агент — что это без памяти
Если совсем коротко: ИИ-агент — это программа, которая под управлением языковой модели решает бизнес-задачу через набор инструментов. Прочитал письмо, вытащил номер заказа, сходил в 1С, ответил клиенту. Всё это в идеале — без человека.
Проблема в том, что базовая языковая модель по своей природе беспамятна. Каждый вызов — с чистого листа. Всё, что модель «знает» о текущем разговоре, лежит в её окне контекста. Закрыли сессию — и через час, если клиент вернулся, агент опять начинает знакомство с нуля.
Для чат-бота, который отвечает на «где мой заказ», это ещё как-то терпимо. Для ИИ-агентов для бизнеса, которые ведут клиента через несколько касаний, согласовывают спецификацию, ждут документы и продолжают разговор через день, — уже нет.
Первый подход: «просто скорми всю историю»
Самое простое, что приходит в голову, когда разбираешься, как создать ИИ-агента с памятью, — это кидать в промпт всю переписку с клиентом. Есть же теперь модели с миллионом токенов контекста, вон Anthropic только что выкатил Claude Fable 5.1 с окном в 1M, да и российские модели заметно подтянулись.
Мы попробовали. Работало ровно до того момента, пока у активного клиента не накопилось несколько десятков обращений. Дальше начались две неприятности.
Первая — деньги. Большое окно не бесплатное. Даже с prompt cache, который сейчас все провайдеры удешевляют, платить за каждый разговор как за небольшую книгу — глупо. И самое обидное, что 95% этого контекста агенту не пригодилось.
Вторая — качество. Модель начинает тонуть в шуме. Клиент три недели назад в одном сообщении упомянул, что «мы обычно работаем через УПД, не через акт». Это важный факт. Но в общей массе переписки про сроки, доставку и цену модель его теряет. Ответ формально верный, а по сути — глухой к тому, что уже обсуждали.
Стало ясно: пихать всё подряд — не решение. Память надо разложить.
Три слоя: короткая, эпизодическая, семантическая
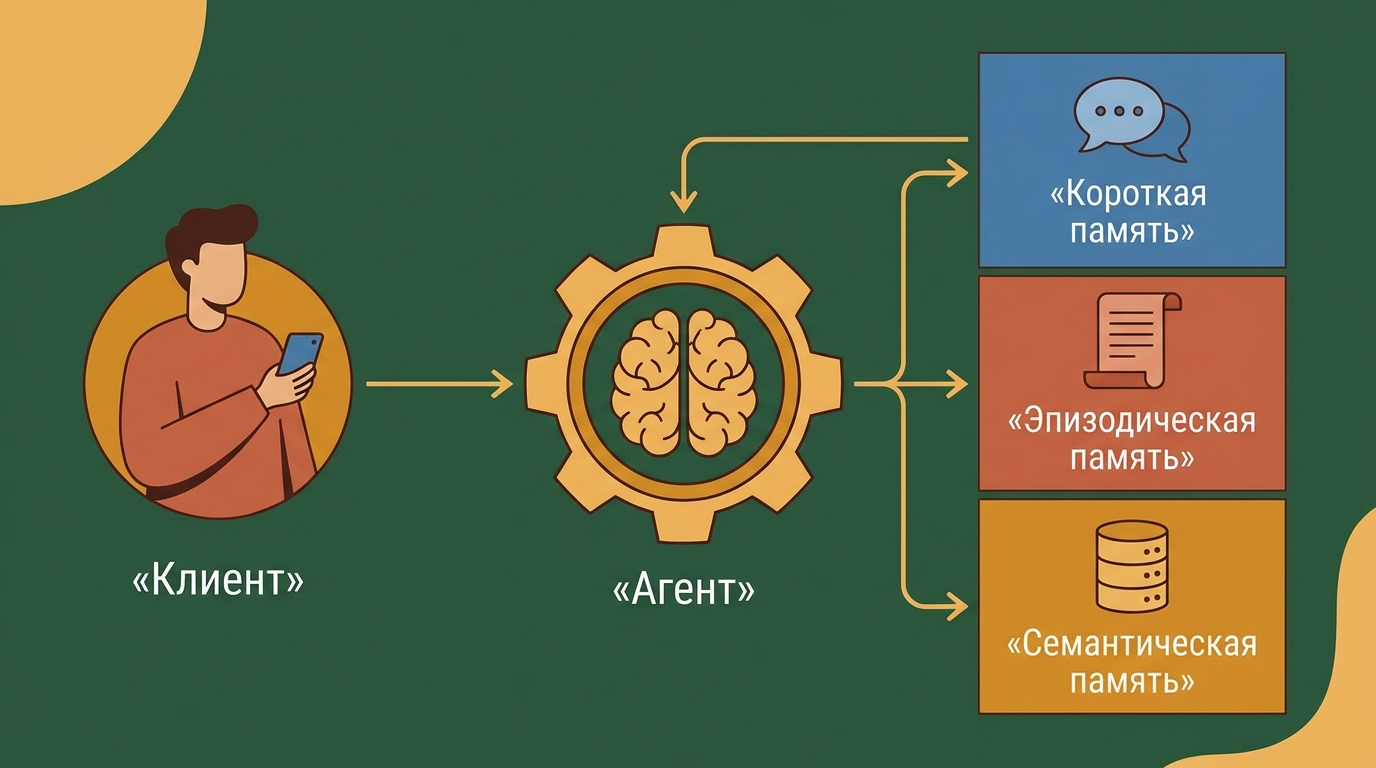
Мы пришли к архитектуре из трёх уровней. Она не наша выдумка — похожие подходы описывают и Cloudflare в своём свежем Agent Memory, и исследователи из академии. Но пока каждый собирает её сам под свой стек.
Короткая память — это то, что помещается в окно контекста прямо сейчас. Последние N сообщений текущей сессии, плюс системный промпт и вызовы инструментов. Живёт в оперативке процесса, умирает вместе с сессией.
Эпизодическая память — свёрнутые в короткое резюме предыдущие разговоры с этим же клиентом. Не сырые сообщения, а выжимка: «обсудили поставку насосов Grundfos, клиент попросил счёт на юрлицо, договорились созвониться в среду». Одно резюме на одну сессию. Лежит в PostgreSQL, привязано к клиенту.
Семантическая память — извлечённые факты о клиенте и его окружении. Не события, а свойства. «Работает через УПД». «Директор — Сергей Петрович, обращается на вы». «Основные объекты — котельные малой мощности». Тут уже pgvector: факты кодируются эмбеддингами, при новом обращении подтягиваются самые релевантные.
Разница между эпизодической и семантической — как между «что случилось» и «что мы знаем». Первое устаревает быстро, второе — медленно.
Как это работает вживую
Клиент открывает диалог. Агент по идентификатору клиента поднимает из базы:
- последние два-три эпизода (короткие резюме прошлых разговоров);
- десяток релевантных фактов из семантической памяти по векторному поиску (запрос — первое сообщение клиента + его профиль);
- пустое окно короткой памяти, куда будут писаться реплики этой сессии.
Всё это склеивается в системный промпт: «Ты общаешься с клиентом X. Что мы о нём знаем: ... . О чём говорили в прошлые разы: ... . Продолжай беседу».
Клиент пишет «а сроки не сдвинулись?». Агент понимает, о чём речь, потому что в эпизодической памяти есть «обсуждали поставку насосов, срок был 15 октября». Идёт в 1С, проверяет, отвечает по-человечески. Никаких «уточните, пожалуйста, о каком заказе идёт речь».
Когда сессия закрывается — не сразу, а после паузы — запускается фоновый воркер. Он делает две вещи. Сжимает переписку в новый эпизод и кладёт в БД. И прогоняет её через отдельный вызов модели с промптом «выдели новые устойчивые факты о клиенте». Найденные факты дедуплицируются (эмбеддинг + косинусная близость к уже сохранённым) и, если это правда что-то новое, ложатся в семантическую память.
Где мы обожглись
Пока собирали, пару раз крепко наступили на грабли.
Первое — забыли про забывание. У активного клиента за полгода накопилось столько эпизодов и фактов, что подтягивать даже верхние — уже долго. Пришлось учить агента забывать. Старые эпизоды сжимаем по нескольку штук в один более общий («в течение осени клиент заказывал насосы и запорную арматуру, средний чек такой-то»). Факты с признаком времени («в этом квартале у нас проект в Череповце») получают TTL и через какое-то время выпадают. Долгоживущие свойства («работает по УПД») остаются навсегда.
Второе — противоречия. Клиент сначала сказал «счёт на ООО Ромашка», через месяц — «теперь оформляйте на ИП Ромашкина». Наивный извлекатель фактов оставит оба, и агент однажды выберет не то. Решили просто: у факта есть версия и дата, извлекатель при новом факте помечает старый как «замещён». Актуальным считается последний непротиворечивый.
Третье — утечки между клиентами. Пока писали быстро, доступ к таблицам эпизодов и фактов рулился в питоновском коде. Один недосмотренный джоин — и агент клиента А начинает подсовывать в промпт факты клиента Б. Про это я уже писал отдельно — мы прикрутили Row Level Security в PostgreSQL, чтобы такое было невозможно на уровне базы, а не на уровне «мы же аккуратно фильтруем».
Четвёртое — 152-ФЗ. Память агента — это персональные данные, причём чувствительные (иногда там оказывается «жена директора работает у поставщика»). Всё хранение — только в российском контуре, шифрование на диске, роль извлекателя фактов инструктирована не таскать в семантическую память ничего, что похоже на здоровье, политические взгляды и прочие спецкатегории. Для проектов, где параноить надо сильнее обычного, крутим агента и его память полностью локально на GigaChat Pro или на открытых российских моделях внутри периметра заказчика.
Что изменилось для людей
Раньше менеджер, разбирая ночную пачку диалогов, половину времени тратил на то, чтобы восстановить, о чём вообще шла речь. Теперь достаточно взглянуть на эпизод-резюме — и всё понятно за пару абзацев.
Клиенты стали заметно спокойнее. Раньше типичное недовольство было «я всё уже писал вчера, вы что, не читаете». Теперь такие жалобы почти исчезли: агент помнит.
Расход на модель тоже стал приличнее. Мы перестали тащить всю переписку в каждый запрос — тащим короткую выжимку и десяток фактов. Порядок токенов на запрос упал ощутимо, а качество ответа — выросло, потому что модель видит суть, а не шум.
И вопрос напоследок
Память ИИ-агента — это уже не «фича на потом». Это то, что отличает разовый чат-бот от полноценного ИИ-агента для бизнеса, с которым клиент выстраивает длинные отношения.
Но есть вопрос, на который у нас пока нет единого ответа: где заканчивается память агента и начинается CRM. Формально семантическая память — это профиль клиента, а профиль клиента должен жить в CRM. На практике CRM не умеет хранить «клиент любит, когда сначала показывают чертёж, а потом обсуждают цену». Мы пока держим это в памяти агента и синхронизируем в CRM только то, что там имеет смысл. Но чувствую, что через год-полтора эту границу будут перекладывать.
Если у вас уже есть свой ИИ-агент — расскажите, где вы провели эту черту. Мы всё ещё ищем красивое решение.
Похожие статьи
- Клиенту велели переехать на GigaChat Pro за квартал: как мы пересобирали чужого ИИ-агента, не сломав ему характер
- Действие с откатом: как ИИ-агенты для бизнеса научились сначала показывать, а потом делать
- OG Default
- В компании оказалось два десятка ИИ-агентов, о которых IT впервые слышал: как мы разбирали этот зоопарк
