- Главная
- Блог
- Внутренняя платформа для создания ИИ-агентов: как мы перестали писать один и тот же код на каждого клиента
Внутренняя платформа для создания ИИ-агентов: как мы перестали писать один и тот же код на каждого клиента
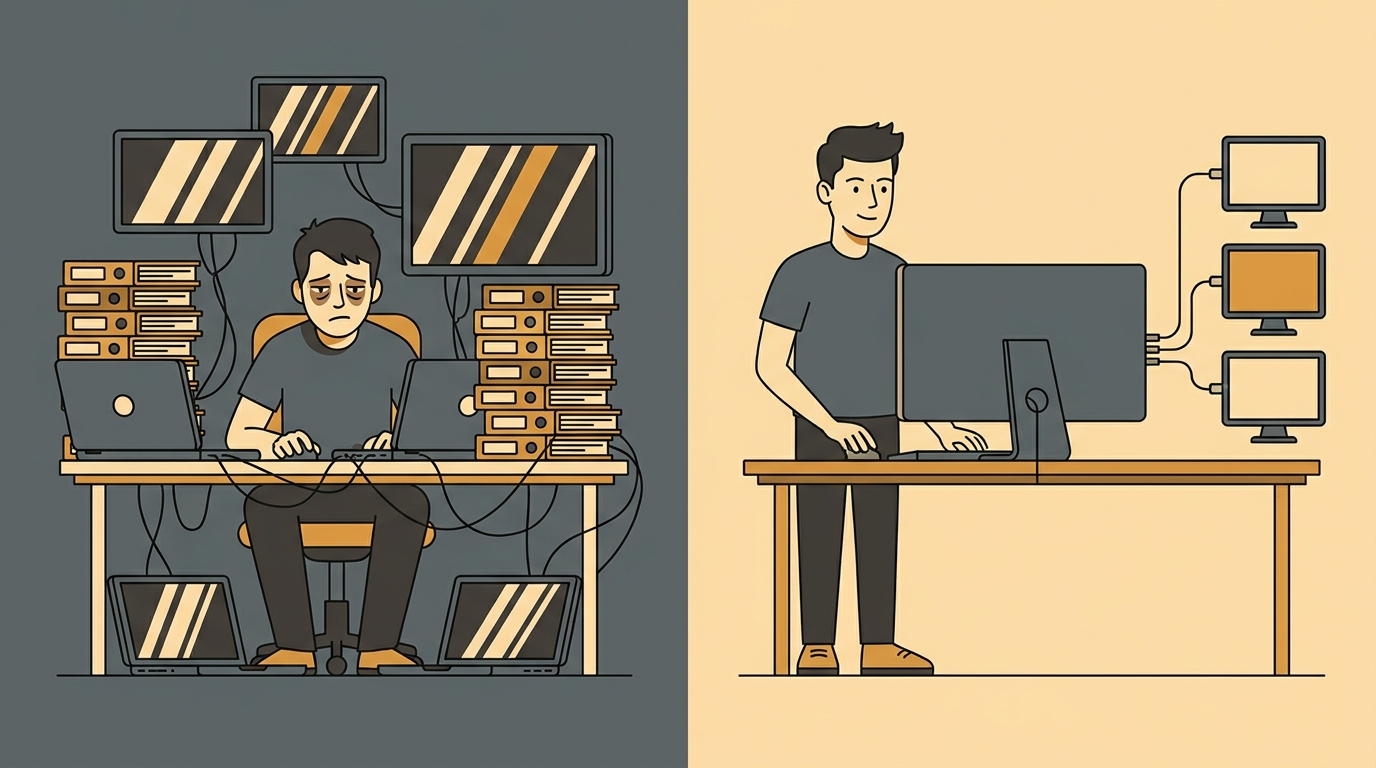
Мы поняли, что пора что-то менять, когда одну и ту же правку в модуле логирования пришлось переносить в четыре разных репозитория подряд. Четыре клиента, четыре ИИ-агента, четыре форка одного и того же скелета. Где-то модуль уже успел разъехаться с оригиналом, где-то кто-то дописал костыль под конкретную интеграцию, а где-то файл вообще назывался иначе, потому что первый разработчик поленился. Классический сценарий: сервис ещё живой, но сопровождать его становится дороже, чем разрабатывать.
Тогда мы и сели рисовать внутреннюю платформу для создания ИИ-агентов. Не продукт для продажи наружу, а именно внутренний конвейер, чтобы завести ИИ-агента в компанию клиента можно было без ощущения, что мы начинаем очередной проект с чистого листа. Ниже — как мы к этому пришли, где сначала ошиблись и что получилось в итоге.
Как мы жили без платформы
Первые несколько внедрений выглядели одинаково по структуре: FastAPI, Angular-фронт, PostgreSQL с pgvector, MCP-сервер к учётной системе клиента, промпты в отдельной таблице. Но код при этом писался под каждого клиента заново. Каждый раз мы поднимали новый репозиторий, копировали куски из предыдущего, немного переименовывали и уходили в конкретику. Ощущалось это как быстрый старт — и это было главной ловушкой.
Через полгода у нас накопилось несколько живых внедрений, и любая общая правка превращалась в квест. Нашли уязвимость в обработке JWT — правь в четырёх местах, помни, что где-то файл переименован, а где-то функция принимает лишний аргумент. Хочешь добавить новую метрику в дашборд — иди по кругу, копируй, тестируй. Мы не то что не успевали делать новых агентов — мы едва успевали чинить старых.
Разработчики стали ворчать. Менеджеры проектов — тоже, потому что каждая мелочь превращалась в отдельную задачу и стоила отдельного времени.
Первый заход: общая библиотека
Как это часто бывает, сначала мы попробовали самое простое: вынесли общий код в отдельный внутренний пакет и подключили его во все проекты через свой pypi-репозиторий. Логирование, аутентификация, обёртки над LLM-провайдерами, базовый слой работы с pgvector — всё в одном месте.
Стало легче, но ненадолго. Проблема оказалась в другом. Каждый агент по-прежнему был отдельным приложением со своим Dockerfile, своими миграциями, своим CI, своим фронтом. Библиотека помогала не писать одинаковый код, но не спасала от одинаковой инфраструктурной обвязки. Плюс началась история с версиями: один клиент застрял на старой версии библиотеки, потому что новая тянула изменения в API, а руки переписать не доходили. Через несколько месяцев мы обнаружили, что поддерживаем библиотеку в трёх версиях одновременно.
Так мы поняли: библиотека — это лечение симптомов. Нам нужна была именно платформа, где ИИ-агент клиента — это не отдельный проект, а конфигурация поверх общего ядра.
Что мы вынесли в ядро
Идея простая на словах и болезненная в реализации: разделить то, что действительно уникально у клиента, и то, что уникальным быть не должно.
Уникальное у клиента — это его данные, его MCP-сервера к учётным системам, его промпты, его брендинг, его правила доступа. Всё остальное — общее: слой аутентификации, работа с LLM (в том числе абстракция, которая позволяет за конфигом переключать GigaChat Pro, YandexGPT, T-Lite или локальную модель под 152-ФЗ), очередь задач, воркеры, работа с pgvector, дашборды, аудит, обработка SIGTERM, retry-логика, circuit breaker к провайдеру.
Всё это переехало в ядро платформы. Один репозиторий, один CI, одна команда, которая за это отвечает. Клиентские сборки стали тонкими: конфигурационные файлы, схема данных, набор MCP-адаптеров и промпты в базе. Развернуть ИИ-агента в новую компанию теперь означает завести нового тенанта, подключить его MCP-сервера, залить промпты и настроить доступы. Раньше на это уходили недели, теперь справляемся быстрее, чем клиент успевает согласовать доступ к своей учётной системе.
Веб-разработка как инфраструктурный код
Отдельно расскажу про фронт, потому что тут мы дольше всего сопротивлялись. Казалось, что Angular-приложения у всех клиентов настолько разные, что общего фронта не сделать. Разный брендинг, разные роли, разные виджеты.
Оказалось, что эффективная веб-разработка и инфраструктурный код для ИИ-агентов уживаются, если правильно провести границу. Мы сделали базовый Angular-модуль с ядром: чат, стриминг ответов, отображение источников из RAG, аудит-лог, панель админа. Всё, что не про конкретный бизнес. А кастомизацию вынесли в тему и конфиг: цвета, логотип, набор виджетов на главной, разрешённые действия по ролям. Клиентские сборки собирают этот модуль как npm-пакет и добавляют свои страницы поверх.
В итоге девяносто процентов интерфейса приходит из ядра, а команда, которая заводит нового клиента, дописывает только то, что действительно уникально. Это очень освободило фронтендеров: они перестали быть узким горлом на каждом внедрении.
Идентичность агента и аудит
Здесь помог свежий тренд. Google в августе выкатил Enterprise Agent Platform с идеей отдельной идентичности агента — чтобы любое действие в чужой системе можно было отследить именно до конкретного агента, а не до общего технического пользователя. Мы про это думали давно, но новостной фон подтолкнул закрыть тему до конца.
У нас теперь каждый ИИ-агент в компании — это отдельная сущность в системе с собственными токенами доступа, собственной областью данных и собственным журналом. Когда агент дёргает MCP-сервер и, скажем, создаёт задачу в 1С, в логах видно: не «system», а конкретный агент с конкретной версией промпта. Это оказалось критично для клиентов, которые беспокоятся про 152-ФЗ и требования регуляторов: любое действие можно объяснить и восстановить.
Пригодилось и в отладке. Когда приходит жалоба «ваш агент почему-то отредактировал не тот документ» — мы за пару минут поднимаем цепочку, а не роемся в общих логах приложения.
Что мы сознательно не стали делать общим
Признаюсь честно: у нас была соблазнительная идея сделать платформу такой умной, чтобы даже промпты и логика диалога генерировались автоматически из описания задачи. Мы это попробовали и отказались.
Работа с промптами и бизнес-логикой у каждого клиента слишком разная, чтобы её обобщать. Как только мы попытались загнать её в шаблон, получили либо агента, который вроде работает у всех, но толком ни у кого, либо шаблон настолько гибкий, что писать конфигурацию в нём стало сложнее, чем писать код. Здесь мы оставили ручную настройку — это та часть, где живой опыт разработчика важнее автоматизации.
Что изменилось
Главное — мы перестали воспринимать ИИ-агентов как штучный продукт. Это превратилось в сервис: мы разрабатываем ИИ-агентов серийно, каждый новый клиент подключается по накатанной, а команда фокусируется на том, что действительно уникально в его бизнесе.
Правки в общей инфраструктуре теперь делаются один раз и разливаются на всех клиентов через обновление ядра. Новые модели встраиваются за счёт того, что абстракция LLM уже сделана — вышел свежий Nemotron или очередной DeepSeek, мы прогоняем на своём стенде и, если результат нравится, добавляем в список доступных провайдеров. Клиент переключается конфигом.
И самое неожиданное — платформа изменила разговоры с заказчиками. Раньше мы обсуждали, как долго будем поднимать инфраструктуру. Теперь обсуждаем то, ради чего он вообще к нам пришёл: какие процессы автоматизировать, какие данные подключать, где границы полномочий агента. То есть говорим про его бизнес, а не про наш техдолг.
Если вы у себя внутри разрабатываете больше двух-трёх ИИ-агентов, задайте один вопрос: сколько раз вы за последний месяц копировали код между репозиториями? Если больше одного — платформа уже нужна. Наш опыт показывает, что чем раньше провести границу между общим и уникальным, тем дешевле обходится каждый следующий агент.
Похожие статьи
- Сколько стоит ИИ-агент: почему честный ответ начинается с проектирования, а не с прайса
- «А ваш ИИ-агент это умеет?» — вопрос, из-за которого мы разложили агента на скиллы
- ИИ-агент, который работает сам на ноутбуке: как мы выбирали open-source модель после августовских релизов
- Что такое сеть ИИ-агентов простыми словами: как мы собрали команду из пяти ролей для разбора техзадания